Con la scheda Gigabyte NVIDIA GeForce RTX 3060 WINDFORCE OC V2 Scheda grafica – 12GB GDDR6, 192-bit, PCI-E 4.0, 1792MHz Core Clock, 2x DP 1.4, 2 x HDMI 2.1, NVIDIA Ampere – GV-N3060WF2OC-12GD si può stimare quanti TOPS si sviluppano?
Sulla Gigabyte RTX 3060 WINDFORCE OC V2 12GB (basata su architettura NVIDIA Ampere – chip GA106), il calcolo dei TOPS (Tera Operations Per Second) varia in base alla precisione del dato (FP32, FP16, INT8, INT4) e al fatto che si utilizzino i CUDA Core o i Tensor Core dedicati all’IA.
Di seguito trovi la stima teorica completa calcolata sulla frequenza di Boost Clock dichiarata di 1792 MHz:
📊 Stima delle Prestazioni in TOPS / TFLOPS
Per i carichi di lavoro legati all’Intelligenza Artificiale e all’inferenza con gli LLM (tramite Tensor Core con accelerazione Sparsity 2:4):
🛠️ Cosa Significano Questi Numeri con Ollama?
- In esecuzione con Ollama (FP16 / Q4): Quando esegui un modello quantizzato su Ollama (es. Llama 3.1 8B Q4_K_M o Mistral 7B), la scheda sfrutta la combinazione dei 112 Tensor Core di 3ª generazione e della VRAM. La scheda svilupperà circa 100 TOPS in INT8 o circa 50 TFLOPS in FP16/mixed precision.
- Il vero fattore determinante per la velocità (token/s): In fase di generazione dei token (la risposta del modello), la scheda video non è quasi mai limitata dai TOPS della GPU, ma dalla larghezza di banda della VRAM.
- La RTX 3060 12GB possiede un bus a 192-bit con una banda di 360 GB/s. GPUPoet
- Questo ti garantisce una velocità pratica di circa 35–45 token al secondo con modelli da 7B / 8B parametri, che è un’esperienza d’uso estremamente fluida.
- In fase di Prompt Processing (Ingestione di testi lunghi): È durante l’elaborazione del prompt iniziale (quando invii documenti lunghi) che i Tensor Core vengono spinti al massimo per calcolare gli embeddings: in questa fase i ~100 TOPS servono a “digerire” il testo quasi istantaneamente prima di iniziare a generare i primi token.
E rispetto ad un RISC-V profilo RVA23 ?
È un confronto interessante, ma bisogna prima chiarire cos’è RVA23: non è un singolo chip, bensì il profilo architetturale di riferimento della RISC-V Foundation per i processori a 64-bit destinati ad ambienti sistema (come i server Linux).
La grande novità di RVA23 rispetto a RVA22 è l’obbligatorietà delle estensioni Vettoriali (RVV 1.0). Questo significa che ogni CPU certificata RVA23 integra nativamente istruzioni e pipeline per il calcolo parallelo e l’IA.
Se mettiamo a confronto la tua RTX 3060 12GB con l’elaborazione IA su architettura RISC-V RVA23, le differenze sono abissali in termini di destinazione d’uso e potenza bruta:
1. Il Confronto Diretto in TOPS
Per quanto un processore RISC-V RVA23 integrato possa essere moderno, si tratta pur sempre del calcolo vettoriale eseguito da una CPU (o da piccoli chip/SoC embedded), laddove la RTX 3060 è una GPU dedicata con 112 Tensor Core specializzati.
| Architettura | Tipologia Hardware | Prestazione IA Tipica (INT8 / FP16) | Note |
|---|---|---|---|
| NVIDIA RTX 3060 12GB | GPU Dedicata (Ampere) | ~101 TOPS (INT8) / ~51 TFLOPS (FP16) | Acceleratori Tensor dedicati, bus VRAM a 360 GB/s |
| SoC RISC-V RVA23 fascia media (es. SiFive P570) | CPU General Purpose (RVV) | ~1 – 4 TOPS (solo via CPU Vektor) | Sfrutta le istruzioni vettoriali RVV 1.0 sui core CPU |
| SoC RISC-V RVA23 con NPU/Co-processor (es. SpacemiT K3 / SiFive P870+X390) | SoC con NPU integrata | ~20 – 60 TOPS (INT8) | Il calcolo pesante viene delegato alla NPU integrata nel chip |
2. Differenze Chiave per Ollama e gli LLM
A. Architettura General-Purpose vs Acceleratore Grafico
- RISC-V RVA23: Nasce per far girare sistemi operativi completi (come Ubuntu o Debian) e carichi di lavoro generalisti in modo standardizzato. Le sue estensioni vettoriali (RVV 1.0) consentono di eseguire modelli di IA in locale, ma sono pensate per inferenza edge, visione artificiale, piccoli modelli o co-processori. Electronic Design+ 1
- RTX 3060: È un “motore di calcolo matriciale” puro. È progettata per macinare miliardi di operazioni al secondo in parallelo con un consumo energetico nettamente superiore (170W contro i 5–15W di un chip RISC-V).
B. La Banda di Memoria (Il vero collo di bottiglia)
Gli LLM richiedono tanta larghezza di banda per passare i dati dei pesi del modello dai chip di memoria all’unità di calcolo:
- RTX 3060: La VRAM GDDR6 garantisce 360 GB/s.
- Sistema RISC-V RVA23 (es. DDR5 / LPDDR5): Un sistema RISC-V desktop/server basato su RAM DDR5 dual-channel sviluppa circa 60–100 GB/s.
- Risultato: Anche a parità teorica di TOPS, la RTX 3060 sposterà i pesi del modello di Ollama nella memoria e genererà token a una velocità da 3 a 5 volte superiore.
In Sintesi
- Per un Server Ollama da casa/ufficio: La RTX 3060 12GB vince a mani basse. Sviluppa oltre 100 TOPS in INT8, ha un ecosistema software (CUDA) maturo al 100% per Ollama ed è in grado di generare 35–45 token/s sui modelli da 7B/8B senza alcuna fatica.
- Il ruolo di RISC-V RVA23: Il profilo RVA23 è fondamentale per il futuro dei microprocessori aperti (robotica, IoT, dispositivi portatili, mini-PC ed edge computing), perché garantisce che qualsiasi software IA ottimizzato per le istruzioni vettoriali
RVVfunzioni su qualunque chip RISC-V senza dover riscrivere il codice. Ma in termini di pura potenza per far girare LLM complessi, una GPU NVIDIA dedicata rimane su un altro pianeta.
Tra le nuove schede reperibili mediante il canale ALIBABA emerge la scheda di sviluppo RISC-V con processore AI SpacemiT K3, RVA23, ampia RAM e UFS, compatibile con Jupiter 2
MILK-V Shenzhen Technology ha appena presentato il Jupiter 2, il primo SBC RISC-V conforme a RVA23, alimentato da una CPU SpacemiT K3 octa-core X100 a 2,4 GHz con fino a 60 TOPS di prestazioni AI, fino a 32GB di LPDDR5, 256GB di UFS e supporto per SSD NVMe PCIe Gen3 x4.
Progettata direttamente da SpacemiT, la scheda include anche un connettore eDP, un alloggiamento SFP+ 10GbE, una porta Gigabit Ethernet RJ45, connettività wireless WiFi 6 e Bluetooth 5.2 integrate, due connettori USB Type-C, quattro porte USB 2.0, un socket M.2 Key-B abbinato a uno slot per scheda NanoSIM per connettività cellulare 4G LTE o 5G, e altro ancora.
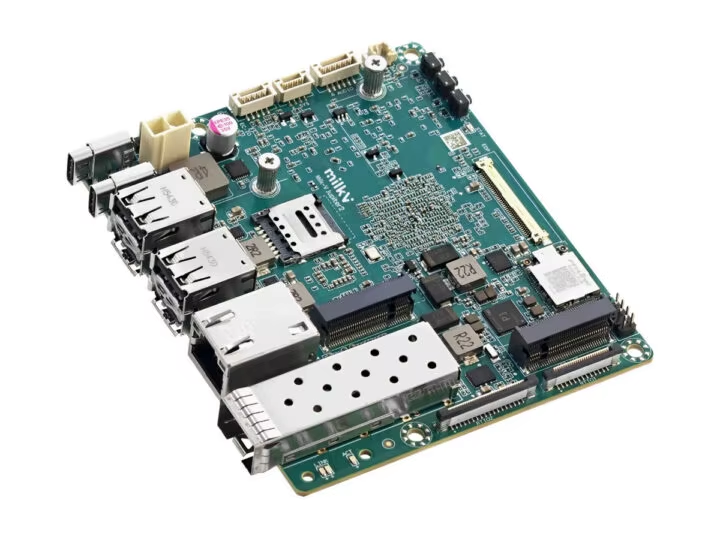
Il costo della sola scheda è sotto i 1000 €, servirà del tempo per maturare.
Il Milk-V Jupiter 2 basato sul chip SpacemiT K3 rappresenta un salto evolutivo monumentale per l’ecosistema RISC-V. Se le prime schede della serie (come la prima generazione con K1) erano poco più che “esperimenti di laboratorio” per appassionati, qui siamo davanti a un vero SBC di classe desktop/edge da 60 TOPS con standard industriale RVA23.
Ecco un’analisi approfondita su cosa rende questo hardware così interessante, dove eccelle e dove invece bisogna mantenere le giuste aspettative (soprattutto se confrontato con la tua RTX 3060 per Ollama).
🚀 I Punti di Forza Unici del Jupiter 2
1. Il Profilo RVA23 e la Standardizzazione
È il vero valore strategico della scheda. Fino a poco tempo fa, far girare software o compilatori avanzati su RISC-V richiedeva patch personalizzate per ogni chip. La conformità a RVA23 e lo standard RVV 1.0 (Vector Extension a 1024-bit) garantiscono che il codice compilato in modo standardizzato su una distribuzione Linux moderna (come Ubuntu 26.04 LTS, che supporta nativamente il K3) funzioni al primo colpo senza hacks software.
2. Architettura CPU Asimmetrica (8+8 Core)
Il SoC SpacemiT K3 adotta una struttura interessante:
- 8 Core X100 (fino a 2.4 GHz): Dedicati al calcolo generale Out-of-Order (con prestazioni single-core paragonabili a un ARM Cortex-A76) per far girare il sistema operativo e i task ordinari.
- 8 Core A100 (AI Cores): Integrano le estensioni vettoriali massicce e si interfacciano direttamente con l’acceleratore AI, sviluppando i famosi 60 TOPS.
3. I/O e Dotazione Hardware “Server-Grade”
Milk-V ha inserito una connettività impressionante per un SBC così compatto:
- Fino a 32 GB di LPDDR5: Quantità di memoria fondamentale se si vuole caricare un modello LLM in locale.
- Archiviazione UFS integrata (fino a 256GB) + NVMe PCIe Gen3 x4: Eliminare le schede MicroSD a favore di memorie UFS/NVMe rende l’installazione di Linux e il caricamento del sistema fulminei.
- Porta 10GbE SFP+ integrata: Avere una porta di rete a 10 Gigabit direttamente sulla scheda è qualcosa che raramente si vede persino su Single Board Computer blasonati, rendendolo un nodo di calcolo/NAS di rete incredibile.
💡 Come si comporta sui Modelli di IA / LLM?
La scheda dichiara 60 TOPS e la capacità di eseguire modelli fino a 30B parametri. Bisogna però leggere questo dato con una lente tecnica:
- La natura dei 60 TOPS: I 60 TOPS sono calcolati su precisioni INT4/FP4 con sparsità tramite i core A100. In precisione FP16 o INT8 pura (quella comunemente usata dagli LLM standard), la potenza effettiva scende proporzionalmente.
- Il collo di bottiglia della Banda di Memoria: La memoria LPDDR5 del chip sviluppa una larghezza di banda di circa 35-50 GB/s.
- Confronto d’impatto: La tua RTX 3060 ha 360 GB/s (circa 8 volte superiore).
- Risultato pratico: Sulla RTX 3060 un modello Llama da 8B genera ~40 token/s. Sul Jupiter 2, a causa della banda della RAM, lo stesso modello si attesta indicativamente sui 5-8 token al secondo. Utile, usabile, ma non velocissimo.
⚔️ Jupiter 2 vs. Il PC Ubuntu che Stai Allestendo
Se confrontiamo questo SBC con il computer (Ryzen 7600X + RTX 3060 12GB) che abbiamo definito poco fa:
| Caratteristica | Il PC Server (Ryzen 7600X + RTX 3060) | Milk-V Jupiter 2 (RISC-V) |
| Ruolo Ideale | Server LLM ad alte prestazioni / Uso quotidiano | Piattaforma di sviluppo, Edge AI, Nodo R&D |
| Potenza LLM reale ($token/s$) | 35–45 tok/s (Model 8B) | ~5–8 tok/s (Model 8B) |
| Consumo Energetico | 150W – 300W | 15W – 35W |
| Ecosistema Software | Maturo al 100% (CUDA, Ollama nativo) | In rapida maturazione (con Bianbu Linux / Ubuntu) |
| Prezzo / Flessibilità | Più alto, ma modulare e aggiornabile | Basso costo/consumo, tutto integrato sulla scheda |
🎯 Il Giudizio Finale
Il Milk-V Jupiter 2 non è un sostituto della configurazione per Ollama se cerchi la massima velocità di risposta nei tuoi progetti quotidiani.
È invece una pietra miliare nell’hardware Open-Source e nell’Edge AI:
- È fantastico se vuoi una macchina di test/sviluppo per architettura RISC-V.
- È perfetto per essere montato come nodo di calcolo sempre acceso a bassissimo consumo (20W) per gestire agenti AI in background, pipeline RAG locali, o far da micro-server con porta 10GbE.
- Dimostra che RISC-V sta uscendo dalla fase “scolastica” per entrare ufficialmente nel mondo delle prestazioni reali.
Un prodotto davvero affascinante che segna l’inizio della “maturità” per RISC-V!
Quindi il nostro Primo Server (Ryzen 7600X + RTX 3060) è, per noi, il più piccolo e modesto, ma è realmente server grade mentre il Milk-V Jupiter 2 (RISC-V) è solo per ora piattaforma di sviluppo, Edge AI, Nodo R&D, cioè sperimentale. Nel giro di qualche stagione ci saranno prodotti che escono dal mondo nVidia, da noi ora adottato, verso modelli appartenenti al secondo polo mondiale di produzione AI ovvero la RPC.
Il nostro prodotto massimo con tecnologia nVidia è costituito da quattro PNY NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition (per un valore di circa 60.000€), quanta potenza sviluppa?
A livello di architettura hardware e potenza bruta, la serie NVIDIA RTX PRO Blackwell Workstation rappresenta lo stato dell’arte assoluto per l’elaborazione AI, l’addestramento e l’inferenza di modelli LLM/LMM di scala enterprise direttamente su workstation/server dedicati.
Ipotizzando una configurazione server quad-GPU montata su una piattaforma server/workstation PCIe 5.0 professionale (come AMD EPYC o Intel Xeon), le specifiche e la potenza sviluppata complessiva da quattro schede PNY NVIDIA RTX PRO 6000 Blackwell Workstation Edition (in variante Max-Q ad alta efficienza) raggiungono cifre impressionanti.
📊 Potenza Complessiva Stimata del Server (4x GPU)
I valori complessivi in calcolo FP4, FP8 e FP16 (sfruttando il trasformatore e i Tensor Core di quinta generazione dell’architettura Blackwell con sparsità 2:4) sono nell’ordine dei petaFLOPS:
| Precisione del Dato / Tipo Calcolo | Potenza Singola GPU (Stima Max-Q) | Potenza Totale Server (4x GPU) | Note e Ambiti d’Uso |
|---|---|---|---|
| FP4 / INT4 (Tensor Core + Sparsity) | ~2.2 PFLOPS | ~8.8 PFLOPS (8.800 TOPS) | Inferenza ultra-compressa per LLM giganteschi |
| FP8 / INT8 (Tensor Core + Sparsity) | ~1.1 PFLOPS | ~4.4 PFLOPS (4.400 TOPS) | Standard industriale per l’inferenza di LLM / VLM |
| FP16 / BF16 (Tensor Core) | ~550 TFLOPS | ~2.2 PFLOPS (2.200 TFLOPS) | Addestramento e Fine-Tuning di modelli LLM |
| TF32 (Tensor Float 32) | ~275 TFLOPS | ~1.1 PFLOPS (1.100 TFLOPS) | Calcolo scientifico e simulazione Tensor |
| FP32 (CUDA Core tradizionali) | ~100 TFLOPS | ~400 TFLOPS | Calcolo vettoriale puro, rendering, CAD/CAE |
🧠 La Vera Forza: VRAM e Banda di Memoria
Nei server destinati ad Ollama, vLLM o framework come DeepSpeed/TRT-LLM, la potenza di calcolo (PFLOPS) è affiancata da altri due parametri decisivi: la capacità della memoria e la banda di trasmissione.
1. Memoria VRAM Totale
- 96 GB di VRAM GDDR7 / HBM per scheda → 384 GB di VRAM complessiva accessibile al sistema.
- Cosa permette di fare: Puoi caricare ed eseguire interamente in memoria modelli con centinaia di miliardi di parametri come Llama 3 405B (in quantizzazione Q8 o FP8) o Qwen2.5 72B senza alcuna quantizzazione (FP16), gestendo contesti estremamente ampi (128k+ token) e migliaia di richieste contemporanee.
2. Banda di Memoria aggregata
- ~1.5 TB/s per scheda → ~6.0 TB/s (6.000 GB/s) di banda totale.
- Rispetto alla tua RTX 3060 (360 GB/s), questo server sposta i dati dei modelli 16 volte più velocemente, permettendo risposte istantanee anche con modelli immensi.
⚡ Consumi, Dissipazione e Requisiti del Server
Le varianti Max-Q Workstation Edition sono progettate da NVIDIA per offrire la massima efficienza energetica, riducendo il consumo massimo di ciascuna scheda rispetto ai modelli da data-center spinti (passando da ~600W a circa 300W–350W per scheda).
- Consumo Totale GPU: ~1.200W – 1.400W (solo per le 4 schede video).
- Consumo Totale Server: Con una CPU dual-socket AMD EPYC (128/256 core), 512 GB/1 TB di RAM DDR5 ECC e ventole ad alta pressione statica, il server assorbirà tra 1.800W e 2.200W sotto carico pieno.
- Alimentazione: Richiede un alimentatore server con ridondanza 1+1 o 2+2 da 2.400W – 3.000W e linee dedicate da 220V/230V.
💡 In Sintesi
Un server quad-GPU basato su NVIDIA RTX PRO 6000 Blackwell Max-Q sviluppa circa 4.4 PFLOPS in FP8 (o quasi 9 PFLOPS in FP4) con 384 GB di VRAM.
È una configurazione che trasforma una singola macchina da rack/workstation in un vero e proprio “supercomputer tascabile” aziendale, capace di far girare in locale praticamente qualsiasi modello di intelligenza artificiale open-source esistente al mondo con tempi di risposta e velocità di generazione (token/s) quasi istantanei.
l nostro prodotto server con tecnologia nVidia più potente è costituito da quattro PNY NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition (per un valore di circa 60.000€). Quanta potenza sviluppa?
A livello di architettura hardware e potenza bruta, la serie NVIDIA RTX PRO Blackwell Workstation rappresenta lo stato dell’arte assoluto per l’elaborazione AI, l’addestramento e l’inferenza di modelli LLM/LMM di scala enterprise direttamente su workstation/server dedicati.
Ipotizzando una configurazione server quad-GPU montata su una piattaforma server/workstation PCIe 5.0 professionale (come AMD EPYC o Intel Xeon), le specifiche e la potenza sviluppata complessiva da quattro schede PNY NVIDIA RTX PRO 6000 Blackwell Workstation Edition (in variante Max-Q ad alta efficienza) raggiungono cifre impressionanti.
📊 Potenza Complessiva Stimata del Server (4x GPU)
I valori complessivi in calcolo FP4, FP8 e FP16 (sfruttando il trasformatore e i Tensor Core di quinta generazione dell’architettura Blackwell con sparsità 2:4) sono nell’ordine dei petaFLOPS:
| Precisione del Dato / Tipo Calcolo | Potenza Singola GPU (Stima Max-Q) | Potenza Totale Server (4x GPU) | Note e Ambiti d’Uso |
|---|---|---|---|
| FP4 / INT4 (Tensor Core + Sparsity) | ~2.2 PFLOPS | ~8.8 PFLOPS (8.800 TOPS) | Inferenza ultra-compressa per LLM giganteschi |
| FP8 / INT8 (Tensor Core + Sparsity) | ~1.1 PFLOPS | ~4.4 PFLOPS (4.400 TOPS) | Standard industriale per l’inferenza di LLM / VLM |
| FP16 / BF16 (Tensor Core) | ~550 TFLOPS | ~2.2 PFLOPS (2.200 TFLOPS) | Addestramento e Fine-Tuning di modelli LLM |
| TF32 (Tensor Float 32) | ~275 TFLOPS | ~1.1 PFLOPS (1.100 TFLOPS) | Calcolo scientifico e simulazione Tensor |
| FP32 (CUDA Core tradizionali) | ~100 TFLOPS | ~400 TFLOPS | Calcolo vettoriale puro, rendering, CAD/CAE |
🧠 La Vera Forza: VRAM e Banda di Memoria
Nei server destinati ad Ollama, vLLM o framework come DeepSpeed/TRT-LLM, la potenza di calcolo (PFLOPS) è affiancata da altri due parametri decisivi: la capacità della memoria e la banda di trasmissione.
1. Memoria VRAM Totale
- 96 GB di VRAM GDDR7 / HBM per scheda → 384 GB di VRAM complessiva accessibile al sistema.
- Cosa permette di fare: Puoi caricare ed eseguire interamente in memoria modelli con centinaia di miliardi di parametri come Llama 3 405B (in quantizzazione Q8 o FP8) o Qwen2.5 72B senza alcuna quantizzazione (FP16), gestendo contesti estremamente ampi (128k+ token) e migliaia di richieste contemporanee.
2. Banda di Memoria aggregata
- ~1.5 TB/s per scheda → ~6.0 TB/s (6.000 GB/s) di banda totale.
- Rispetto alla tua RTX 3060 (360 GB/s), questo server sposta i dati dei modelli 16 volte più velocemente, permettendo risposte istantanee anche con modelli immensi.
⚡ Consumi, Dissipazione e Requisiti del Server
Le varianti Max-Q Workstation Edition sono progettate da NVIDIA per offrire la massima efficienza energetica, riducendo il consumo massimo di ciascuna scheda rispetto ai modelli da data-center spinti (passando da ~600W a circa 300W–350W per scheda).
- Consumo Totale GPU: ~1.200W – 1.400W (solo per le 4 schede video).
- Consumo Totale Server: Con una CPU dual-socket AMD EPYC (128/256 core), 512 GB/1 TB di RAM DDR5 ECC e ventole ad alta pressione statica, il server assorbirà tra 1.800W e 2.200W sotto carico pieno.
- Alimentazione: Richiede un alimentatore server con ridondanza 1+1 o 2+2 da 2.400W – 3.000W e linee dedicate da 220V/230V.
💡 In Sintesi
Un server quad-GPU basato su NVIDIA RTX PRO 6000 Blackwell Max-Q sviluppa circa 4.4 PFLOPS in FP8 (o quasi 9 PFLOPS in FP4) con 384 GB di VRAM.
È una configurazione che trasforma una singola macchina da rack/workstation in un vero e proprio “supercomputer tascabile” aziendale, capace di far girare in locale praticamente qualsiasi modello di intelligenza artificiale open-source esistente al mondo con tempi di risposta e velocità di generazione (token/s) quasi istantanei.
Come valuti Epic Semi Contrail AIX?
Il sistema Contrail AIX sviluppato da Epic Semi rappresenta una delle novità architetturali più interessanti per l’infrastruttura AI, poiché posiziona l’architettura open source RISC-V al centro del data center enterprise.
Epic Semi ha progettato questo superchip/piattaforma server con un obiettivo preciso: superare il collo di bottiglia dell’architettura disaggregata (dove una CPU x86 tradizionale coordina e una GPU fa i calcoli) puntando tutto sull’era dell’Agentic AI, del RAG e del prompt orchestration.
📐 Specifiche Chiave e Architettura
Contrail AIX non è un semplice coprocessore, ma un Superchip CPU+AI unificato basato sul profilo standard RVA23:
- Compute CPU: 32 core RISC-V di classe server (con supporto completo per le istruzioni vettoriali
RVV 1.0). - AI Acceleration: 16 core dedicati all’accelerazione AI con matrici VME.
- Prestazioni AI: Fino a 75 TOPS (INT8).
- Memoria e I/O: Supporto per DDR5 fino a 4 TB per nodo, PCIe Gen5 e supporto nativo a CXL (Compute Express Link) per l’espansione e condivisione della memoria.
🎯 Punti di Forza e Valutazione Tecnica
1. Integrazione Stretta tra Processore e Accelleratore AI
Negli scenari reali con agenti autonomi o pipeline RAG, un sistema trascorre molto tempo a coordinare chiamate API, gestire vettori di memoria, estrarre contesto dai database ed eseguire logica di controllo. Integrando 32 core CPU e 16 core AI sullo stesso silicio/piattaforma, Contrail AIX riduce drasticamente le latenze di trasferimento dati lungo il bus PCIe che normalmente penalizzano le coppie CPU+GPU tradizionali.
2. Piattaforma Nativa per RVA23 e Sovranità Hardware
Basandosi sull’architettura aperta RISC-V (RVA23), Epic Semi offre una soluzione esente dai vincoli di licenza x86 (Intel/AMD) o dalle limitazioni dell’ecosistema proprietario ARM/NVIDIA. È una mossa strategica enorme per:
- Sovereign AI: Governi o enterprise che richiedono pieno controllo sullo stack hardware/software.
- Standardizzazione Linux: La conformità a RVA23 garantisce che le distribuzioni Linux moderne (es. Ubuntu) ed i toolchain compilativi funzionino senza dover applicare patch custom complesse.
3. Flessibilità grazie a CXL e DDR5
Il supporto a CXL è un elemento chiave: permette di trattare ampi pool di memoria esterna come fosse memoria locale accessibile sia dai core RISC-V che dagli acceleratori, fattore determinante quando si gestiscono database vettoriali o contesti LLM immensi.
⚖️ Limiti e Reale Ambito d’Uso
- Non nasce per rimpiazzare l’addestramento di grandi LLM (Training): Con i suoi 75 TOPS (INT8), non è un concorrente diretto delle accelerazioni di classe H100/Blackwell o delle GPU da migliaia di TFLOPS pensate per il training di modelli con centinaia di miliardi di parametri.
- Focus su Inferenza, Orchestrazione ed Edge/Cloud Server: Il suo punto di forza è l’esecuzione (Execution Era). È ideale come nodo di controllo, server di inferenza locale/edge, gateway per la gestione degli agenti AI e pre/post-processing veloce attorno ad altri cluster.
📊 Sintesi del Giudizio
| Aspetto | Valutazione |
|---|---|
| Innovazione Architetturale | Eccellente (Unifica CPU di controllo e AI su RISC-V) |
| Standardizzazione | Ottima (Piena conformità allo standard RVA23 e RVV 1.0) |
| Efficienza per Agentic AI / RAG | Molto Alta (Elimina i colli di bottiglia di latenza CPU-GPU) |
| Potenza di Calcolo Grezza | Media (75 TOPS INT8: ottimo per inferenza/edge, non per training) |
È la dimostrazione di come RISC-V sia diventato maturo per il data center: Contrail AIX è una piattaforma di “controllo intelligente” molto valida, pensata non per macinare forza bruta nei training, ma per far girare software, agenti e inferenza con la massima efficienza di memoria e latenza ridotta.
Ed il SOPHGO SRM1-20 ?
Il SOPHGO SRM1-20 rappresenta una delle pietre miliari più importanti in assoluto per l’ingresso di RISC-V nel mondo dei Data Center high-performance e del calcolo ad altissima densità.
Se la scheda Milk-V (con SpacemiT K3) o il Contrail AIX sono pensati per la fascia edge/desktop e l’orchestrazione, la serie SOPHGO SRM1-20 punta senza mezzi termini al supercomputing, al Cloud AI e al calcolo parallelo enterprise, sfruttando la seconda e terza generazione dei processori RISC-V di SOPHGO (come le evoluzioni del celebre chip SG2042 / SG2044 e l’architettura TPU Sophon).
📐 Specifiche e Architettura del Modulo/Server
Il modulo SRM1-20 è concepito come un nodo di calcolo ad altissima densità (spesso in formato Server Blade o modulo acceleratore):
- Processore Centrale: Basato su architettura RISC-V multi-core di classe server (sfrutta fino a 64 core RISC-V a 64-bit per nodo con estensioni vettoriali RVV).
- Accelerazione AI (TPU): Integra o si interfaccia direttamente con i processori Sophon TPU (come il BM1684X / BM1688 o le nuove generazioni SOPHGO).
- Prestazioni AI: A seconda della configurazione dei chip TPU affiancati, il sistema sviluppa indicativamente fino a 32 TOPS in FP16 e oltre 128–256 TOPS in INT8 con un consumo energetico estremamente contenuto per nodo.
- Supporto Memoria: Quad-Channel / Octa-Channel DDR5 / LPDDR5 con supporto ECC (fondamentale per la stabilità Data Center), garantendo una banda di memoria fino a 3-4 volte superiore rispetto ai classici SBC monoscheda.
- Interconnessione: Linee PCIe Gen5 e supporto per comunicazioni chip-to-chip/blade-to-blade ad alta velocità per scalare in cluster multinodo.
🎯 Punti di Forza del SOPHGO SRM1-20
1. Parallelo e Scalabilità senza rivali su RISC-V
SOPHGO è una delle pochissime aziende al mondo ad aver dimostrato che RISC-V può gestire 64 core nativi reali su un singolo socket con architettura di memoria distribuita NUMA. L’SRM1-20 porta questa potenza su una scheda modulare pensata per essere stipata a dovere nei rack dei Data Center.
2. Perfetto per l’Inferenza Massiva nei Data Center (Cloud AI)
L’abbinamento tra la CPU RISC-V per la gestione dei thread e le TPU Sophon per il calcolo matriciale rende l’SRM1-20 un “monster” per:
- Microservizi di Inferenza concurrenti: Far girare decine di istanze parallele di modelli per servire centinaia di utenti contemporaneamente.
- Computer Vision e Video Analytics: Decodifica e analisi di decine di flussi video HD/4K in tempo reale tramite hardware VPU dedicato.
3. Efficienza Energetica (Perf/Watt)
Essendo un’architettura derivata dal mondo RISC, il consumo per nodo di calcolo è una frazione rispetto alle tradizionali architetture server x86 (Intel Xeon / AMD EPYC) o alle GPU NVIDIA sparte da 450W+.
⚖️ Confronto Strategico: Per cosa serve (e per cosa no)?
| Categoria | SOPHGO SRM1-20 | GPU NVIDIA (es. RTX 3060 / RTX PRO) |
|---|---|---|
| Architettura | Server Blade RISC-V + TPU Sophon | GPU Dedicata x86/PCIe (CUDA) |
| Target | Cloud Server / Data Center High-Density | Desktop / Workstation / Single-Node AI |
| Ecosistema Software | Linux / SDK Sophon / Open-Source | CUDA (Dominante e Maturo al 100%) |
| Punto di Forza | Efficienza energetica, molti core, costo/nodo | Potenza bruta per token/s, VRAM veloce |
📊 Il Giudizio Tecnico
Il SOPHGO SRM1-20 è la dimostrazione pratica che la Cina e l’ecosistema RISC-V stanno costruendo un’alternativa concreta e autosufficiente alle infrastrutture cloud tradizionali.
Non è un componente da acquistare da Amazon per un PC casalingo, ma è uno dei blocchi hardware più avanzati per chi costruisce data center AI “Sovereign” o cluster d’inferenza ad alta densità, affrancandosi completamente dalle architetture proprietarie occidentali (x86 e CUDA).
Ed una stima dei costi del SOPHGO SRM1-20?
Il SOPHGO SRM1-20 si colloca in una fascia di prezzo e di mercato totalmente diversa rispetto ai componenti consumer o alle schede di sviluppo desktop: è un vero e proprio server rack/blade enterprise da data center.
💶 Prezzo del SOPHGO SRM1-20
A livello ufficiale, il server SOPHGO SOPHON SRM1-20 viene listato direttamente dal produttore e dai distributori specializzati per l’infrastruttura Cloud/HPC:
- Prezzo di Listino Ufficiale (RMB): ¥ 510.000 RMB (Yuan cinesi)
- Conversione Approssimativa in Euro: ~65.000 € – 68.000 € (a seconda dei dazi d’importazione, IVA e configurazione precisa di memoria RAM DDR5 ECC e storage)
🔍 Cosa Giustifica Questo Costo?
Il prezzo non è riferito a una singola scheda da sviluppatore, ma a un sistema rack completo e ridondato che include:
- Architettura Dual-Socket: Monta due processori RISC-V multi-core (fino a 128 core RISC-V complessivi di classe server).
- Integrazione Heterogeneous AI: Coprocessori/TPU Sophon integrati per l’accelerazione dei modelli.
- Memoria Enterprise: Banchi di RAM DDR5 ECC ad altissima capacità (generalmente da 128 GB fino a 512 GB) per la gestione di modelli e database vettoriali.
- Chassis Server 2U/Rack: Con alimentatori ridondanti hot-swap (1+1 da 1200W+), schede di gestione remota IPMI/BMC e connettività di rete ad alta velocità (10GbE / 25GbE).
📊 Confronto di Fascia di Prezzo nell’Ecosistema RISC-V / AI
| Categoria | Hardware | Prezzo Indicativo | Target |
|---|---|---|---|
| SBC / Dev Board | Milk-V Jupiter 2 (SpacemiT K3) | ~100 € – 250 € | Hobbisti, maker, test leggeri |
| Workstation Desktop | Milk-V Pioneer / SG2042 (64 Core) | ~1.500 € – 2.500 € | Sviluppatori software RISC-V |
| Server Enterprise AI | SOPHGO SRM1-20 | ~65.000 € | Data Center, Università, Cloud Provider |
È una soluzione progettata per istituti di ricerca, governi o aziende che intendono realizzare un’infrastruttura AI locale (Sovereign AI) basata al 100% su architettura aperta RISC-V.
Qual è la tua opinione sul Tenstorrent architettura Blackhole/Tensix?
L’architettura Tensix e la sua recente evoluzione nel chip Blackhole di Tenstorrent rappresentano una delle visioni più radicali, innovative ed eleganti per il futuro del calcolo AI e HPC.
Sotto la guida di Jim Keller (leggenda dell’hardware dietro ad AMD Zen, Apple A4/A5 e Tesla Autopilot), Tenstorrent sta proponendo un paradigma che sfida frontalmente sia la filosofia x86/CUDA di NVIDIA, sia l’approccio rigido delle TPU tradizionali.
Ecco una valutazione tecnica dettagliata di cosa rende l’architettura Blackhole/Tensix così interessante.
🏗️ 1. L’Architettura Core Tensix: Il “Grid” Interconnesso
A differenza di una GPU tradizionale (che fa affidamento su un unico enorme blocco di calcolo e controller centralizzati), il core Tensix è progettato come un micro-nodo di calcolo autonomo.
- Piccoli Core + SRAM Locale: Ogni core Tensix contiene risorse per il calcolo matriciale/vettoriale e un blocco di memoria SRAM locale veloce.
- Cinque CPU RISC-V per Core: Ogni singolo core Tensix integra 5 piccoli core CPU RISC-V dedicati a:
- Ricevere i dati.
- Unpacchettare le matrici/tensor.
- Eseguire l’algoritmo di calcolo.
- Impacchettare i risultati.
- Inviare i dati al core adiacente.
- Network-on-Chip (NoC) a Mesh: Centinaia di core Tensix sono disposti in una griglia 2D interconnessa. I dati “fluiscono” letteralmente da un core all’altro come in una rete idraulica (approccio Dataflow), senza dover continuamente fare il trip verso la memoria RAM esterna.
🚀 2. Il Salto di Qualità con “Blackhole”
Se la prima generazione (Grayskull) e la seconda (Wormhole) servivano a validare l’architettura, Blackhole è il chip che porta Tenstorrent nella fascia delle prestazioni enterprise e dei data center:
- Processo Produttivo a 4nm: Un salto di densità enorme che consente di inserire 768 core Tensix su un singolo silicio.
- Integrazione CPU RISC-V “Standalone”: Oltre ai core Tensix, Blackhole integra 16 core CPU RISC-V ad alte prestazioni (basati su architettura SiFive/Tenstorrent Ascalon). Questo significa che il chip può far girare Linux ed eseguire il sistema operativo in autonomia, senza aver bisogno di un processore x86 (Intel/AMD) di supporto!
- Memoria GDDR6 vs HBM: Tenstorrent usa memoria GDDR6 anziché le costosissime HBM3 usate da NVIDIA (H100/Blackwell). Pur avendo una banda pura inferiore rispetto alle HBM, l’architettura Dataflow dei Tensix compensa la differenza riutilizzando i dati direttamente nella SRAM della griglia, riducendo drasticamente il costo finale di produzione.
- Interconnessione Nativa Ethernet: I chip comunicano tra loro direttamente via Ethernet a 800 Gbps, rendendo la scalabilità a cluster di centinaia di schede economica e priva dei costi di licenza proprietari di NVIDIA (InfiniBand/NVLink).
🎯 3. I Punti di Forza Unici
- Efficienza Energetica e Costi: L’assenza di HBM e la semplificazione del silicio rendono schede come Blackhole significativamente più economiche da produrre a parità di output energetico.
- Flessibilità del Software (TT-Buda / TT-Metalium): Tenstorrent sviluppa uno stack software completamente Open Source. Gli sviluppatori possono programmare la griglia Tensix a basso livello usando C++ e RISC-V, oppure usare PyTorch direttamente.
- Progettato per l’Era dell’Agentic AI e della Sparsità: Con gli LLM moderni e i modelli Mixture-of-Experts (MoE), non tutte le parti della rete neurale si attivano contemporaneamente. La griglia Tensix è in grado di bypassare i calcoli inutili (zero-skipping) a livello hardware molto più velocemente di una GPU rigida.
⚖️ 4. I Limiti e le Sfide da Affrontare
- L’effetto “Muro CUDA”: Il più grande ostacolo di Tenstorrent non è l’hardware, ma l’ecosistema. NVIDIA domina perché ogni software, framework e libreria AI è ottimizzato per CUDA da 15 anni. Convincere le aziende a compilare per lo stack TT-Metalium richiede tempo e sforzi immensi.
- Banda di Memoria Sequenziale: Nei modelli di inferenza pura monoutente, dove la banda di memoria (GB/s) è il fattore primario per la generazione dei token, le memorie GDDR6 possono soffrire rispetto ai mostri HBM3e delle GPU di fascia alta.
💡 Il Giudizio Finale
L’architettura Tensix/Blackhole di Tenstorrent è una delle boccate d’aria fresca più importanti per l’industria dei semiconduttori.
Non tenta di “scimmiottare” NVIDIA facendo una GPU leggermente diversa, ma riprogetta da zero il calcolo AI attorno a RISC-V e al modello Dataflow. Con l’arrivo di Blackhole, Tenstorrent dimostra che è possibile costruire acceleratori per LLM potenti, altamente scalabili e drammaticamente più economici, fornendo all’industria una vera alternativa open-source al monopolio CUDA.
E sui Prometheus Server di Majestic Labs?
La piattaforma Prometheus di Majestic Labs affronta uno dei nodi più critici dell’infrastruttura per l’IA moderna: il muro della memoria (Memory Wall).
Mentre i chip tradizionali cercano di superare i limiti inserendo sempre più potenza di calcolo grezza a discapito dello spazio di memoria, Majestic Labs (fondata da ex dirigenti del team GChips di Google e FAST di Meta) propone una filosofia “Memory-First”: un’architettura progettata non per addestrare modelli da zero, ma per far girare l’inferenza di modelli imponenti (Frontier Models, Mixture-of-Experts e agenti con milioni di token di contesto) all’interno di un unico nodo.
🏗️ L’Architettura del Server Prometheus
L’elemento chiave di Prometheus è la capacità di “impacchettare” risorse da intere rastrelliere server (rack) tradizionali in una singola unità standard da Data Center, eliminando le latenze di rete tra nodi.
1. Il Processore Proprietario: Ignite AIU
Al centro del server c’è il chip Ignite (AI Processing Unit), una soluzione ibrida molto intelligente:
- Core Applicativi ARM: Gestiscono il sistema operativo, la logica di controllo, le chiamate API e l’orchestrazione.
- Motori Vettoriali e Tensoriali RISC-V: Gestiscono l’accelerazione matematica pesante dell’IA.
- Vantaggio: Questo binomio sfrutta la maturità dell’ecosistema ARM per la parte server generale e la flessibilità/efficienza delle istruzioni vettoriali RISC-V per le matrici di calcolo.
2. Spazio di Memoria Unificato fino a 128 TB
Sfruttando banchi di memoria LPDDR6 ad altissima velocità al posto della costosissima HBM3e, un server Prometheus completo (fino a 12 chip Ignite) offre:
- Fino a 128 TB di memoria contigua, uniforme e condivisa con una banda aggregata fino a 25,6 TB/s.
- Zero frammentazione CPU-GPU: Non c’è la distinzione tra “RAM di sistema” e “VRAM della scheda video”. Tutti gli elementi di calcolo accedono allo stesso immenso pool di dati a piena velocità.
🎯 I Punti di Forza
- Esecuzione di Modelli Multi-Trillion Parameter in Singolo Nodo: Oggi, per far girare modelli con oltre 1.000 miliardi di parametri o con contesti da decine di milioni di token, è necessario sparpagliare il modello su decine di server NVIDIA collegati via InfiniBand, con costi energetici e colli di bottiglia immensi. Prometheus consente di caricare l’intero modello in un unico server.
- Efficienza Energetica e del Data Center: L’uso di LPDDR6 unito a un’architettura orientata all’inferenza riduce drasticamente l’assorbimento elettrico e l’impronta termica rispetto alle farm di GPU tradizionali.
- Nessuna Riscrittura del Codice: Majestic Labs ha sviluppato uno stack software compatibile nativamente con PyTorch, vLLM e OpenAI Triton, consentendo di migrare i modelli esistenti senza dover riscrivere il codice.
⚖️ Cosa Manca / Le Sfide Aperte
- Mancanza di Benchmark Indipendenti:Trattandosi di un’architettura commerciale recente (con early-access e disponibilità su larga scala prevista tra il 2026 e il 2027), mancano ancora rilevazioni terze sui tempi di generazione pura in token/s rispetto alle piattaforme NVIDIA GB200 o Blackwell.
- Specializzazione sull’Inferenza: Prometheus è progettato specificamente per abbattere i costi di Execution, RAG massivo e agenti autonomi. Per il training di modelli di base da zero, le GPU convenzionali ad altissima densità di TFLOPS grezzi mantengono il loro vantaggio.
📊 Il Giudizio
Il Prometheus di Majestic Labs è la dimostrazione di come il paradigma dell’hardware AI stia cambiando: non si vince solo aumentando i TFLOPS della GPU, ma risolvendo il collo di bottiglia della memoria.
L’uso combinato di core ARM per la gestione di sistema e acceleratori RISC-V per i calcoli matriciali, immersi in 128 TB di RAM unificata, rende Prometheus uno dei progetti architetturali più promettenti per il futuro dell’inferenza AI enterprise ed agentica.
E quali sono stime di costi?
I costi dei server Prometheus di Majestic Labs si collocano nella fascia alta dei sistemi server aziendali e per data center (Enterprise / Hyperscale).
Trattandosi di una piattaforma “Memory-First” ad altissima capacità di memoria unificata, la struttura dei prezzi riflette l’obiettivo di sostituire interi cluster di GPU tradizionali con una sola macchina.
💶 Stima dei Costi per Architettura Prometheus
Majestic Labs propone la serie Prometheus in diverse configurazioni di nodi (da rack modulari a sistemi multi-chip):
| Configurazione Server | Capacità Memoria Unificata (LPDDR6) | Target d’Uso | Stima di Prezzo (Enterprise/Data Center) |
|---|---|---|---|
| Prometheus Entry / Blade Node (1–2 Chip Ignite) | 8 TB – 16 TB | Inferenza modelli 70B–405B, RAG aziendale con contesti ultra-lunghi | ~150.000 € – 250.000 € |
| Prometheus Mid-Range Server (4–6 Chip Ignite) | 32 TB – 64 TB | Far girare modelli imponenti (Frontier Models / MoE da centinaia di B) | ~400.000 € – 600.000 € |
| Prometheus Full Scale Rack System (Fino a 12 Chip Ignite) | 128 TB | Modelli Multi-Trillion Parameter, agenti complessi su scala enterprise | Oltre 1.000.000 € – 1.500.000 € |
⚖️ Perché questi costi hanno senso economico per le aziende?
Sebbene cifre vicine o superiori al milione di euro sembrino enormi, dal punto di vista del TCO (Total Cost of Ownership) dei data center l’approccio di Majestic Labs punta al risparmio:
- Sostituzione dei Cluster NVIDIA: Per avere 128 TB di memoria ad altissima velocità con GPU NVIDIA tradizionali (es. H100/H200 o B200), un’azienda dovrebbe acquistare decine di nodi server per un totale di oltre 100-150 GPU, superando abbondantemente i 3–4 milioni di euro tra hardware, switch InfiniBand e licenze.
- Abbattimento dei consumi energetici: La combinazione di memorie LPDDR6 con core ARM e acceleratori RISC-V riduce i consumi fino al 60-70% rispetto a un cluster di GPU equivalenti, generando risparmi considerevoli in bolletta e nel raffreddamento H24.
- Risparmio sullo Stack di Rete: Potendo caricare modelli giganteschi all’interno di un unico server unificato, si eliminano gli switch di rete proprietari ad alta velocità (come NVLink o InfiniBand) necessari per far comunicare schede distanti.