Dialogo con Claude.
Proviamo a creare una prima lezione per il alboratorio AI per il Liceo e l’Istituto Tecnico. Iniziamo da cosa sia il neurone artificiale. Possiamo semplificare che sia una n-pla di elementi di tipo integer nella memoria del computer. Un dato in ingresso è un’altra n-pla. Il programma AI calcola un prodotto scalare coinvolgendo una terza n-pla detta pesi e somma ad una ulteriore n-pla detta bias. Nel suo comportamento numerico: Il risultato grezzo viene filtrato da una funzione matematica che ne limita e modella l’output, decidendo se e con quale intensità il segnale debba propagarsi al livello successivo. Potremo continuare… Come possiamo portare questo a livello di Liceo w Istituto Tecnico?
Costruendo analogie ed esempi numerici per spiegare il neurone.
Ottima idea per la prima lezione — il punto delicato è che la tua definizione è corretta ma “parla” al livello di un corso di algebra lineare, non a un quindicenne. La strategia migliore è: parti da un’analogia intuitiva, arriva alla matematica per gradi, e lascia l’algebra vettoriale esplicita solo alla fine come “formalizzazione” di qualcosa che hanno già capito a intuito.
Ecco come strutturerei il primo blocco della lezione.
1. Aggancio motivazionale: il neurone come “un piccolo giudice”
Invece di partire dalla n-pla, parti da una domanda quotidiana che i ragazzi già risolvono mentalmente pesando più fattori:
“Decidi se uscire stasera. Guardi tre cose: quanto sei stanco, se hai compiti per domani, se i tuoi amici escono. Ogni fattore però non pesa uguale — magari ‘compiti per domani’ ti blocca più di tutto il resto.”
Questo è già, in forma naturale, esattamente ciò che il tuo modello descrive: input multipli, importanza diversa per ciascuno (i pesi), una soglia di decisione (bias + funzione di attivazione).
2. Dalla metafora al calcolo (senza dire “prodotto scalare”)
A questo punto introduci i numeri, ma senza nominare vettori o n-uple. Di’ semplicemente: “diamo un voto a ogni fattore, e un peso a ogni voto”.
| Fattore | Voto (input) | Peso |
|---|---|---|
| Stanchezza | 3 | 0,5 |
| Compiti | 8 | 1,2 |
| Amici escono | 9 | 0,8 |
Poi fai il calcolo a mano alla lavagna: moltiplica ogni voto per il suo peso, somma tutto, aggiungi un bias (che puoi presentare come “quanto sei di base pigro o intraprendente”). Ottieni un numero grezzo.
Qui i ragazzi fanno concretamente quello che il tuo testo chiama “prodotto scalare + bias”, senza che tu debba nominare l’oggetto algebrico. Solo dopo, se la classe (soprattutto l’Istituto Tecnico) è pronta, formalizzi: “quello che abbiamo appena fatto a mano ha un nome preciso: prodotto scalare tra due n-uple, più un termine di bias”.
3. La funzione di attivazione come “valvola”, non come formula
Per la parte che hai descritto come “filtro che limita e modella l’output”, usa l’immagine dell’interruttore o del dimmer:
- Interruttore (a scatti): se il numero supera una certa soglia → “esco” (1), altrimenti → “resto a casa” (0). Questa è la versione più semplice da far digerire (funzione a gradino).
- Manopola del volume (graduale): invece di sì/no secco, l’intensità del segnale cresce morbidamente — è più realistico ma richiede di mostrare una curva (sigmoide) senza necessariamente scriverne la formula al primo incontro.
Direi: al Liceo fermati all’interruttore e magari mostri la curva “a S” solo come disegno, senza formula. All’Istituto Tecnico puoi già scrivere la formula della sigmoide o della ReLU, perché avranno più familiarità col formalismo.
Un diagramma può aiutare parecchio qui per fissare visivamente il flusso — te ne preparo uno.
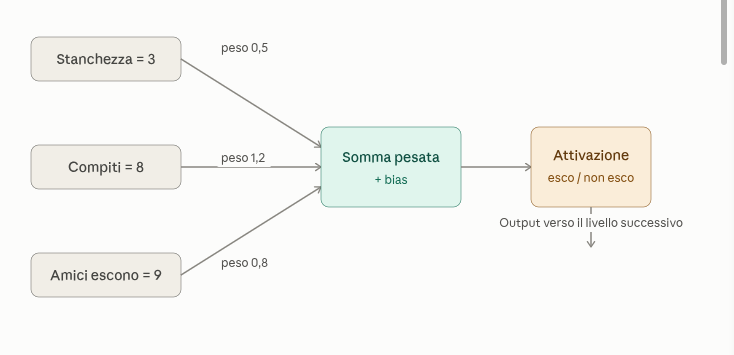
Questo diagramma è esattamente quello che puoi lasciare come “immagine finale” alla lavagna dopo aver fatto il calcolo con l’esempio della serata fuori: i ragazzi vedono che l’immagine formalizza qualcosa che hanno già fatto a mano coi numeri.
4. Differenziazione Liceo vs Istituto Tecnico
- Liceo (soprattutto Scientifico/Classico): enfatizza il parallelo con il neurone biologico (dendriti = input, sinapsi = pesi, soma = somma, assone = output solo se si supera la soglia) e la dimensione epistemologica: perché chiamiamo questo “intelligenza”? Cosa significa che una macchina “decide”? Puoi collegarti a filosofia della mente se il curricolo lo prevede.
- Istituto Tecnico: puoi spingerti prima verso la formalizzazione matematica esplicita (n-pla come vettore, prodotto scalare, notazione Σ) e magari già in questa prima lezione mostrare 3 righe di pseudocodice o persino Python con
numpy.dot(), perché avranno gli strumenti algebrici e la naturale propensione al codice.
5. Chiusura della prima lezione
Una buona chiusura per il primo incontro è far intuire perché serve più di un neurone: un singolo neurone può solo tracciare un confine di decisione molto semplice (rifiuto/accetto). Puoi lasciare come domanda aperta: “e se il problema fosse troppo complesso per essere descritto da pesi fissi su pochi fattori?” — è il gancio naturale per la lezione successiva su reti di neuroni e apprendimento (come vengono “imparati” i pesi).
estiamo sulla funzione di attivazione — è il pezzo più “matematico” ma anche il più bello da rendere intuitivo, perché lega direttamente all’immagine dell’interruttore/manopola che abbiamo già dato.
Prima di tutto un grafico che mostra visivamente le tre funzioni più comuni, così i ragazzi vedono a colpo d’occhio la differenza tra “a scatti” e “graduale”:
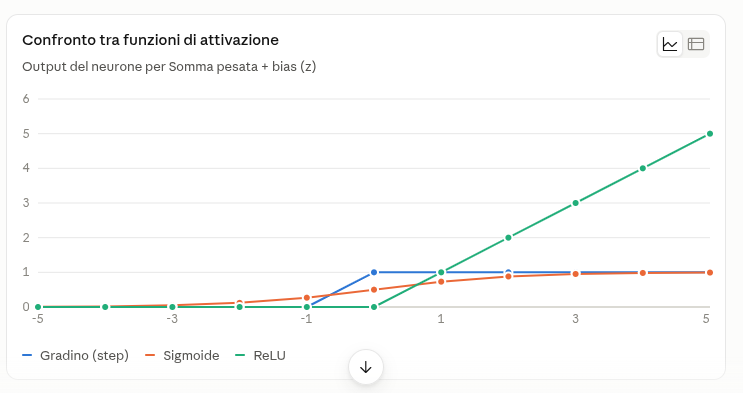
Ora costruiamo il ragionamento didattico attorno a questo grafico, chiamando z il numero grezzo che avevamo ottenuto prima (somma pesata + bias).
Le tre funzioni, dalla più semplice alla più usata
1. Il gradino (step function) — è l'”interruttore” di cui parlavamo:
Semplicissima da spiegare, ma ha un difetto che conviene solo accennare al Liceo e approfondire all’Istituto Tecnico: è “a scatti”, quindi non permette al sistema di capire quanto si è vicini o lontani dalla soglia — passa da 0 a 1 di colpo, senza sfumature. Questo la rende poco adatta a un sistema che deve “imparare” correggendo un po’ alla volta i propri pesi (lo vedremo nella lezione sull’apprendimento).
2. La sigmoide — è la “manopola” graduale:
Osservando il grafico: quando z è molto negativo l’output tende a 0, quando z è molto positivo tende a 1, e attorno a z = 0 c’è una transizione morbida a forma di “S”. Storicamente è stata la prima funzione usata perché è liscia (differenziabile), qualità fondamentale per l’apprendimento automatico — ma per ora possiamo lasciarlo come “dettaglio che spiegheremo quando parleremo di come la rete impara”.
3. ReLU (Rectified Linear Unit) — la più usata oggi nelle reti moderne:
Concettualmente è la più semplice di tutte: “se il segnale è negativo, spegnilo del tutto; se è positivo, lascialo passare così com’è, senza deformarlo”. È anche la più veloce da calcolare per un computer, motivo per cui ha in gran parte sostituito la sigmoide nelle reti profonde.
Attività pratica in classe
Riprendi l’esempio della serata (voti 3, 8, 9 con pesi 0,5 / 1,2 / 0,8 e un bias, es. −5). Fai calcolare a mano con la calcolatrice (serve solo il tasto ex):
- il valore grezzo z (prodotto scalare + bias),
- il risultato con la sigmoide,
- il risultato con ReLU.
Poi discuti insieme: “la sigmoide mi dà un numero tipo 0,87 — posso interpretarlo come l’87% di probabilità che tu esca?” È un ottimo spunto per introdurre, senza tecnicismi, l’idea che l’output di un neurone spesso si legge come una specie di “confidenza” nella decisione, non solo un sì/no secco.
Differenziazione
- Liceo: fermati al confronto qualitativo (guardare il grafico, capire “a scatti vs graduale vs lineare-con-taglio”) e all’interpretazione probabilistica della sigmoide. Evita di insistere sulla derivabilità.
- Istituto Tecnico: puoi accennare già ora perché la derivabilità conta (“il gradino non si può ‘correggere gradualmente’ perché la sua pendenza è quasi sempre zero o infinita”), preparando il terreno alla discesa del gradiente nella lezione sull’apprendimento.
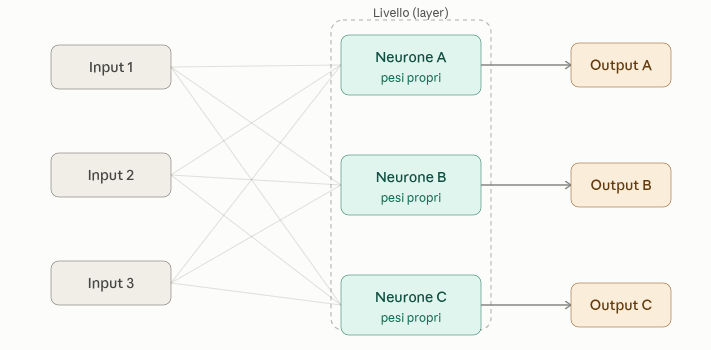
Continuiamo: quando mettiamo più neuroni fianco a fianco, che ricevono tutti gli stessi input ma con pesi propri e indipendenti, otteniamo quello che si chiama un livello (layer).
Il punto chiave da far emergere
Ogni input (Input 1, 2, 3) è collegato a tutti e tre i neuroni del livello, ma ciascun neurone ha il proprio insieme di pesi e il proprio bias. È come se avessimo tre “giudici” diversi che guardano tutti gli stessi tre fattori (stanchezza, compiti, amici che escono), ma ognuno dà loro importanza diversa e prende una decisione propria: uno magari valuta “vado in pizzeria”, un altro “resto a studiare”, un altro ancora “chiamo un amico”.
Un modo efficace di farlo intuire in classe: riprendi l’esempio della serata, ma ora chiedi ai ragazzi di inventare tre giudici diversi con pesi diversi sugli stessi tre fattori, e calcolare a mano i tre output. Vedranno da soli che stesso input, pesi diversi → decisioni diverse. Questo è già, concettualmente, tutto ciò che serve per capire perché una rete con tanti neuroni può rappresentare comportamenti molto più ricchi di uno solo.
Perché conta il numero di neuroni per livello
Ogni neurone del livello impara a “guardare” l’informazione in modo leggermente diverso. Più neuroni in un livello, più “punti di vista” diversi sugli stessi dati — è il primo passo per spiegare, più avanti, perché le reti con molti neuroni riescono a cogliere pattern complessi che un singolo neurone non potrebbe mai catturare (il limite di cui avevamo parlato alla fine della prima lezione).
Differenziazione
- Liceo: fermati alla metafora “più giudici diversi sugli stessi fatti” — è già un salto concettuale enorme e sufficiente per capire cosa distingue un livello da un neurone singolo.
- Istituto Tecnico: qui puoi introdurre la matrice dei pesi — invece di un solo vettore di pesi, ora hai una matrice dove ogni riga è il vettore di pesi di un neurone. Il calcolo dell’intero livello diventa un prodotto matrice-vettore, il che è un ottimo aggancio se hanno già fatto matrici in matematica, o un’anticipazione se non le hanno ancora fatte.
l prossimo passo naturale sarebbe impilare più livelli uno dopo l’altro (l’output di un livello diventa l’input del successivo) — è lì che nasce la “rete neurale profonda” vera e propria.
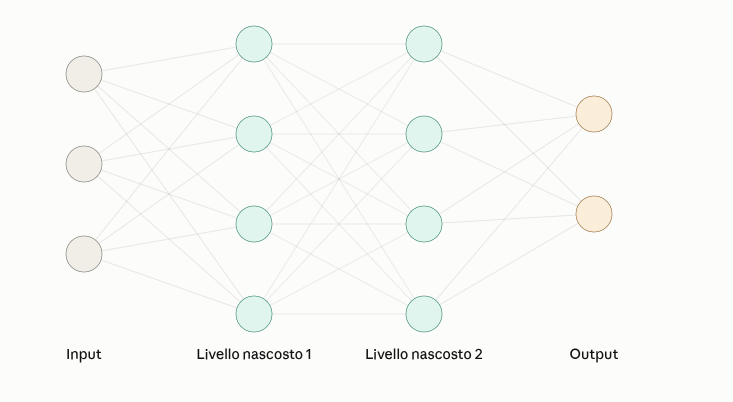
Ecco il passo finale di oggi: cosa succede quando impiliamo più livelli uno dopo l’altro.
Cosa cambia rispetto a un solo livello
Nella rete profonda, l’output di un livello diventa l’input del livello successivo. Ogni neurone del secondo livello nascosto non guarda più i dati grezzi, ma guarda già le “decisioni parziali” prese dal primo livello. Ripetendo il processo più volte, ogni livello costruisce un’interpretazione più astratta di quella del livello precedente.
L’analogia più efficace da usare in classe (soprattutto se il laboratorio toccherà anche il riconoscimento di immagini) è questa progressione:
- Input: i singoli pixel di un’immagine.
- Primo livello nascosto: rileva contorni e bordi semplici.
- Secondo livello nascosto: combina i bordi in forme (un occhio, un orecchio).
- Output: combina le forme in un giudizio finale (“è un gatto”).
Nessun neurone da solo “sa” cosa sia un gatto — è la composizione di tanti giudizi semplici, livello dopo livello, a costruire qualcosa di complesso. Questo è il senso della parola “profonda” (deep) in deep learning: non è un aggettivo di marketing, indica letteralmente il numero di livelli impilati.
Un punto da sottolineare bene con la classe
Il calcolo che attraversa tutta la rete, dall’input all’output, ha un nome preciso che vale la pena introdurre ora: propagazione in avanti (forward propagation). È esattamente la sequenza di operazioni che abbiamo costruito passo passo in questa lezione: prodotto scalare + bias → attivazione → passa al livello successivo → si ripete.
Differenziazione
- Liceo: fermati alla metafora “bordi → forme → oggetto” e al fatto che la profondità permette astrazioni via via più complesse. È un ottimo gancio anche per una discussione più ampia su cosa significhi “comprendere” per una macchina.
- Istituto Tecnico: qui puoi già nominare che il numero di livelli e di neuroni per livello sono scelte progettuali (chiamate iperparametri), e che nella prossima lezione vedrete come i pesi di tutti questi livelli vengono aggiustati automaticamente tramite l’apprendimento (backpropagation) — non li scrive a mano il programmatore.
Con questo hai una progressione completa per la prima lezione: neurone singolo → funzione di attivazione → livello di neuroni → rete profonda.